 Ранее мы установили pg_profile с дополнительными расширениями, собрали два отчёта для эксперимента с генератором демобазы. Настало время проанализировать разделы этих отчётов.
Напомню что было два эксперимента. Я установил значение параметра gen.max_hops генератора демобазы в 1, выполнил генерацию на 1 месяц на 12 процессов, потом поменял gen.max_hops в 10 и повторил. Соответственно, получилось два снимка — для max_hops = 1 и max_hops = 10.
Напомню что описание разделов отчёта pg_profile можно и нужно прочитать в официальной документации на гитхаб: Sections of a report.
Оглавление:
- 1. Server statistics → Database statistics
- 2. Server statistics → Cluster I/O statistics
- 3. Server statistics → Statement statistics by database
- 4. Cluster statistics
- 5. SQL query statistics → Top SQL by execution time
- 6. SQL query statistics → Top SQL by I/O wait time
- 7. SQL query statistics → Top SQL by shared blocks fetched
- 8. User function statistics → Top functions by total time
- 9. Server statistics → Wait sampling
- 10. SQL query statistics → Rusage statistics
- Краткий итог
Итак — поехали!
1. Server statistics → Database statistics
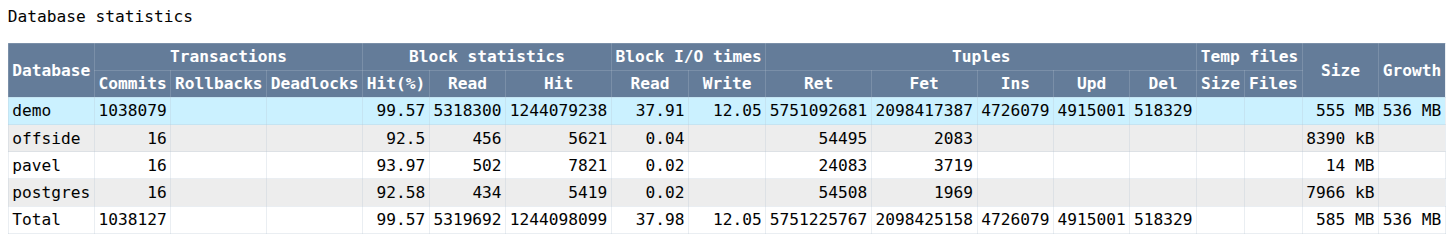
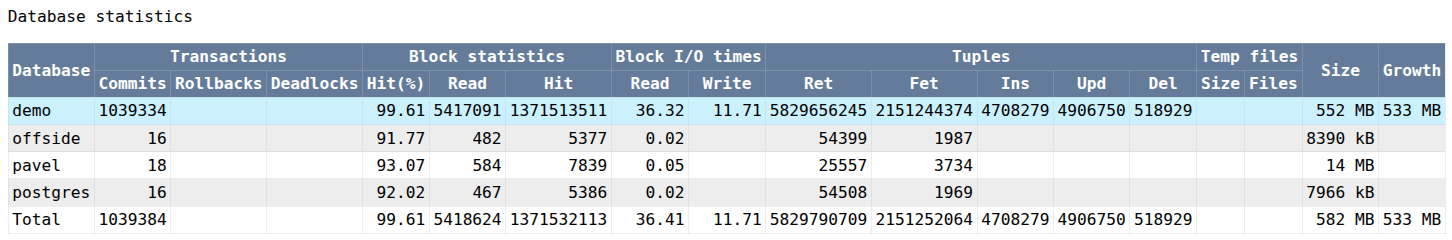
Данные из этого раздела получены из представления pg_stat_database. Часть этих чисел мы уже смотрели в эксперименте со статистическими представлениями.
Посмотрим на Block statistics → Read и Hit. Во втором случае их стал больше, причём Hit увеличился чуть ли не на 10 процентов!
Алгоритм усложнился, это потребовало больше чтений, похоже, но эти чтения удалось выполнить из памяти.
Посмотрим и на Tuples → Ret и Fet (количество возвращенных и извлечённых строк), тут тоже рост. Но давайте, для интереса, посмотрим сколько пришлось извлечь строк (Ret) чтобы получить одну (Fet), ну т. е. Ret/Fet:
hops1: 5751092681/2098417387 = 2,74
hops10: 5829656245/2151244374 = 2,71
Абсолютные цифры больше, но относительное кол-во работы даже немного снизилось.
Размер БД (Size) неожиданно уменьшился, во всех предыдущих экспериментах он рос. Посмотрим на кол-во Ins:
hops1: 4726079
hops10: 4708279
-17800 (-1%)
Меньше вставленных строк — меньше размер, хотя отличие крошечное 🙂
2. Server statistics → Cluster I/O statistics
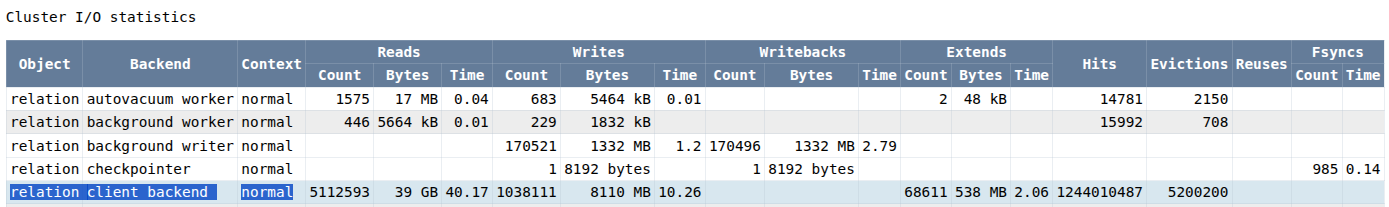
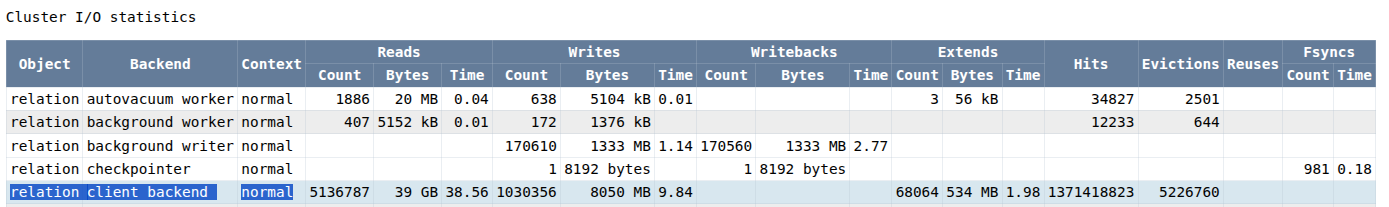
Когда мы рассматривали pg_stat_io, мы обратили внимание на:
«работу обслуживающих процессов (backend_type = ‘client backend’) для постоянных таблиц (object = ‘relation’) и стандартного контекста операций ввода-вывода (context = ‘normal’).»
В pg_profile, в разделе Cluster I/O statistics посмотрим туда же — Writes → Count в этот раз уменьшился:
hops1: 1038111
hops10: 1030356
-7755 (-1%)
В прошлый раз было почти плюс 31 тысячу. Текущее уменьшение count опять вызывано уменьшением добавленных/обновлённых строк. Но надо напомнить что Writes → Count — это сколько страниц клиентский процесс сам сбросил на диск. Это число будет зависить ещё и от активности/настроек bgwriter’a, до него мы ещё доберёмся.
А в этом разделе ещё посмотрим на Reads → Count
hops1: 5112593
hops10: 5136787
+24194 (^1%)
Небольшой рост, выше мы уже видели, что чтений из общего буфера (Hit) было больше, но немного чтений с диска пришлсь сделать дополнительно.
И ещё один момент — связь с ранее рассмотренным столбцом Database statistics → Block statistics → Hit (показывает когда любые процессы в данной БД попадают в память при чтении) и текущим разделом Cluster I/O statistics → Hits (при данном фильтре показывает когда клиентские сессии обращаются к таблицам и попадают в память):
hops1 → Hit: 1244079238
hops1 → Hits: 1244010487
hops10 → Hit: 1371513511
hops10 → Hits: 1371418823
Почти не отличаются! Т.е. в момент эксперимента у нас в базе только эта нагрузка и велась — другие процессы не вмешивались.
3. Server statistics → Statement statistics by database


Суммы значений из представления pg_stat_statements, т. е. это уже статистика запросов.
Посмотрим на Time (s) → Exec (время выполнения запросов, сумма total_time или total_exec_time из pg_stat_statements):
hops1: 20853.75
hops10: 21037.4
+183,65 (^1%)
Гигантский рост в один процент! Получается что при max_hops = 10 запросы работают столько же, сколько и при max_hops = 1.
И посмотрим на Fetched (blk) → Shared (общее число чтений страниц — сумма shared_blks_read + shared_blks_hit из вышеназванного представления):
hops1: 5567134683
hops10: 6457290738
+890156055 (^16%)
И ещё придётся посмотреть на следующий столбец Read (blk) → Shared (в документации не нашёл этого пункта, но, надеюсь, это shared_blks_read из представления — чтения с диска):
hops1: 25464330
hops10: 25583096
+118766 (^1%)
Снова рост на один процент — т. е. с диска чтений не добавилось.
Так что запросы стали читать больше на 16 процентов данных (и почти не увеличились чтения с диска), продолжаем подтверждать то, что уже видели — второй эксперимент активнее читает из общей памяти. При этом время выполнения осталось таким же, пока памяти хватает — всё хорошо (не тратим время на чтения с диска).
4. Cluster statistics
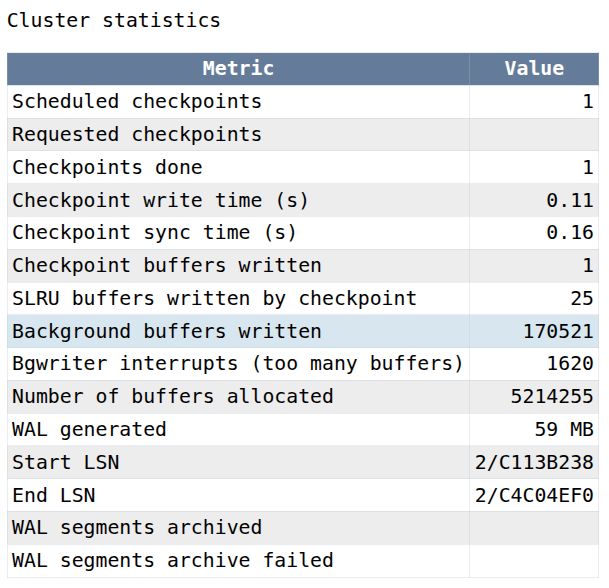
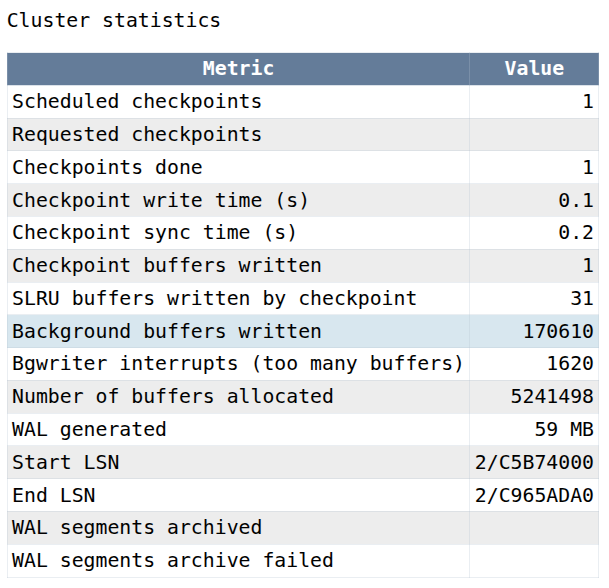
Конкретно два рассмотренных поля берутся из pg_stat_bgwriter.
Тут я буду без конкретных цифр. Просто хочу чтобы вы обратили внимание на:
- Background buffers written — почти не изменились значения;
- Bgwriter interrupts (too many buffers) — значения идентичны.
Можно сделать вывод что процесс фоновой записи (bgwriter) не стал записывать больше данных на диск. А если вспомнить Cluster I/O statistics → Writes → Count (т. е. обслуживающие клиентские процессы тоже не особо много скидывал на диск), то дополнительная работа при max_hops = 10 с работой с диском не связана.
5. SQL query statistics → Top SQL by execution time
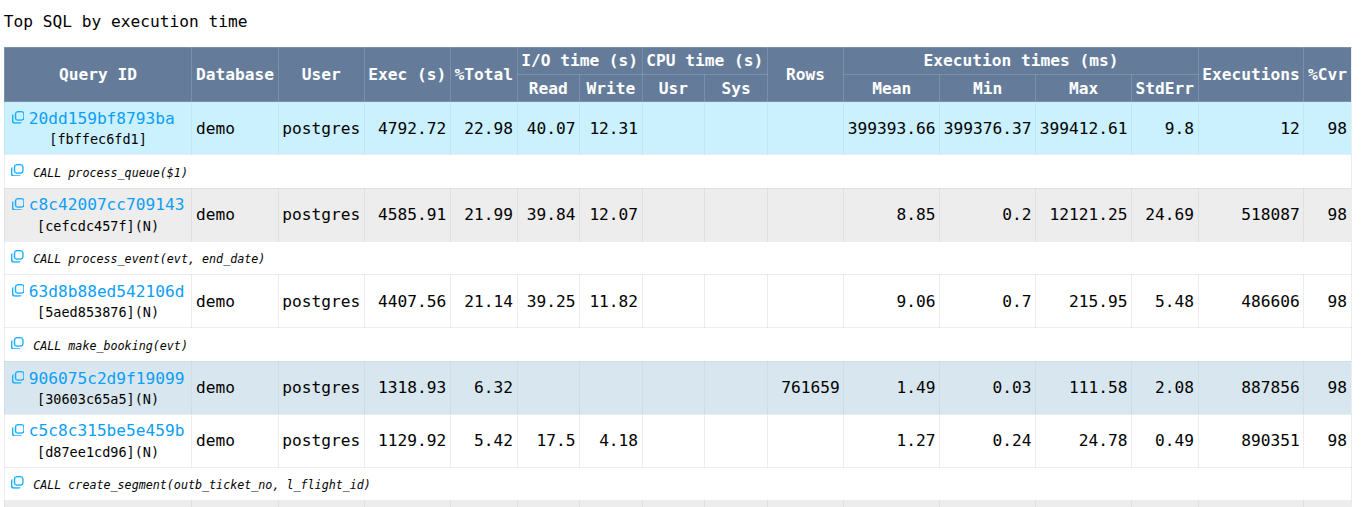

Данные опять из представления pg_stat_statements, т. е. это уже статистика запросов (почти весь раздел SQL query statistics оттуда данные берёт).
В моих экспериментах со статистическими представлениями я отфильтровал информацию только по некоторым запросам, в Top SQL by execution time конечно-же можно увидеть и побольше информации. Но самые нагруженные процедуры я в тот раз всё-же увидел.
Опять буду без цифр. Время выполнения этих подпрограмм не изменилось (Exec). И видно что никакие дополнительные процедуры-функции не появились, т. е. для max_hops = 10 источники нагрузки остались такими же.
6. SQL query statistics → Top SQL by I/O wait time

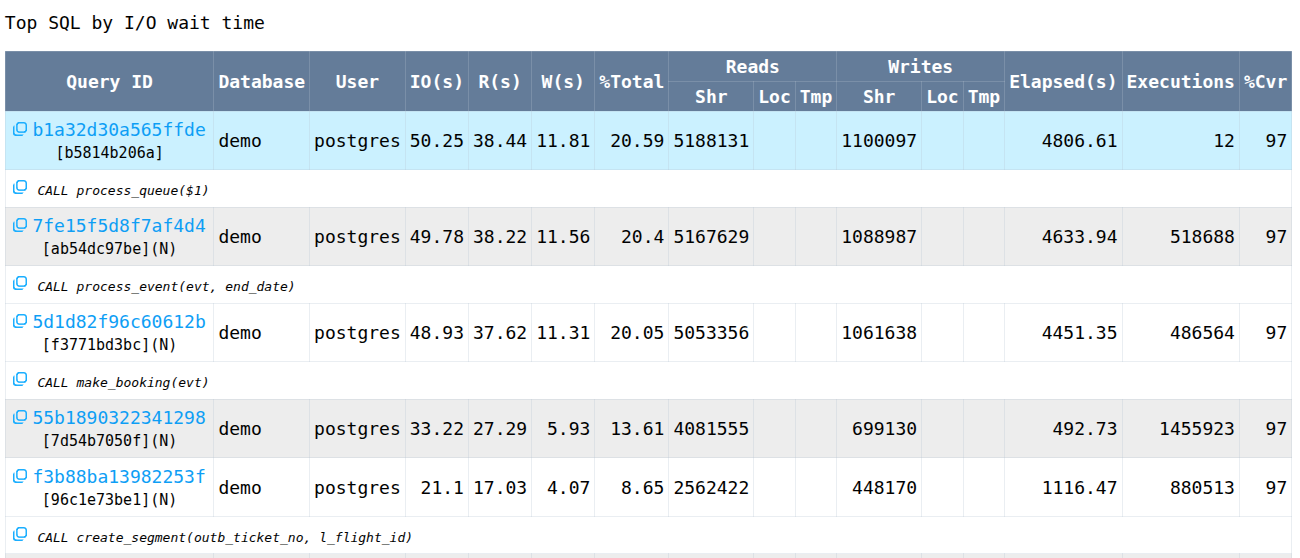
Данные тоже из представления pg_stat_statements.
И снова без цифр. Время ввода-вывода (IO(s), R(s), W(s)) немного сократилось, хотя количество блоков, прочитанных запросом — немного увеличилось (Reads → Shr). Никаких новых ожиданий не появилось, всё стабильно.
7. SQL query statistics → Top SQL by shared blocks fetched


Данные тоже из представления pg_stat_statements.
Тут уже, наконец-то, посмотрим цифры — на blks fetched (количество полученных блоков), возьмём сумму топ-три запроса:
hops1: 3332708747
hops10: 3877129978
+544421231 (^16%)
Рост 16%. Нечто похожее уже видел выше — рост обработки данных, почти вся эта работы была проведена в оперативной памяти. А вот остальные окружающие цифры почти не меняются.
8. User function statistics → Top functions by total time
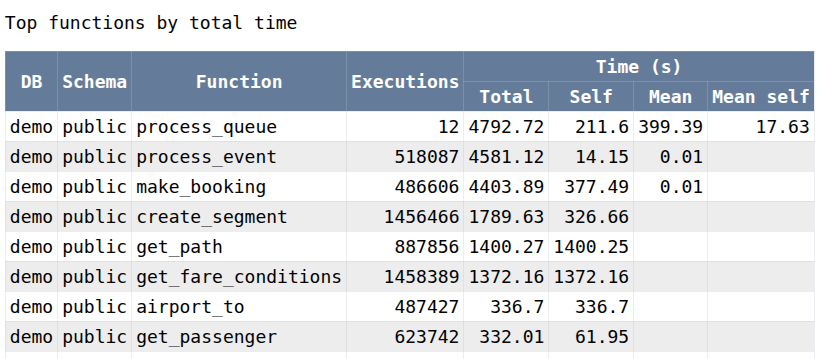
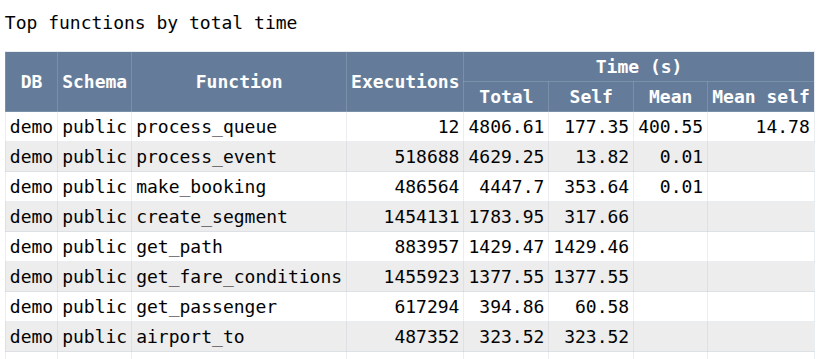
А данные для этого раздела берутся из pg_stat_user_functions (я его не использовал в своём эксперименте, у меня тогда не получилось — не дождался выполнения всех подпрограмм, но данные эти получить можно).
В подтверждение слов выше — посмотрим на топ подпрограмм по времени. Опять без цифр, там рост около одного процента. Можно чуть внимательнее посмотреть на Time (s) → Total и Self. Self — это время на выполнение кода непосредственно указанной подпрограммы (без суммирования вложенных). Для process_queue self-время даже меньше стало.
9. Server statistics → Wait sampling
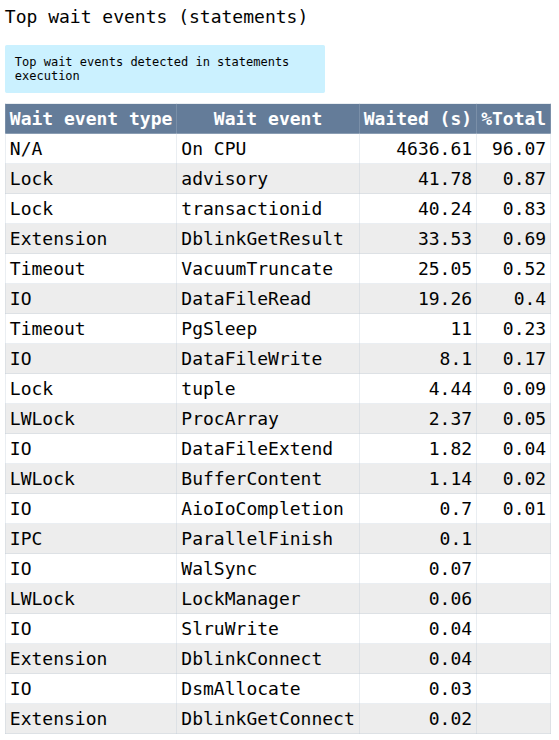
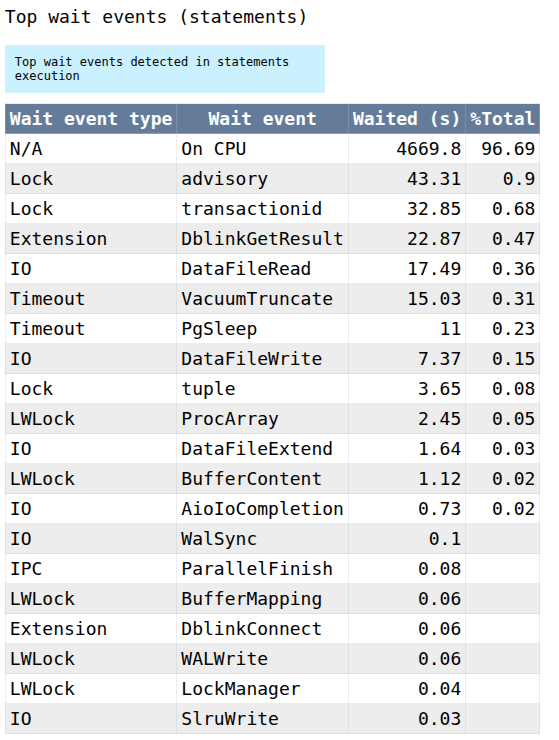
Тут несколько таблиц, посмотрим на Top wait events (statements).
Здесь данные предоставленные расширением pg_wait_sampling — не зря же мы его устанавливали!
Тут посмотрим на два события ожидания: On CPU и DataFileRead:
On CPU:
hops1: 4636.61
hops10: 4669.8
+33,19 (^1%)
DataFileRead:
hops1: 19.26
hops10: 17.49
-1,77 (9.2%)
Опять те же проценты роста — один процент роста на CPU. А ожидание DataFileRead (каюсь, не читал что оно означает, но ощущаю что это чтение файлов — как раз чтение файлов данных на диске) даже уменьшилось почти на десять процентов!
10. SQL query statistics → Rusage statistics
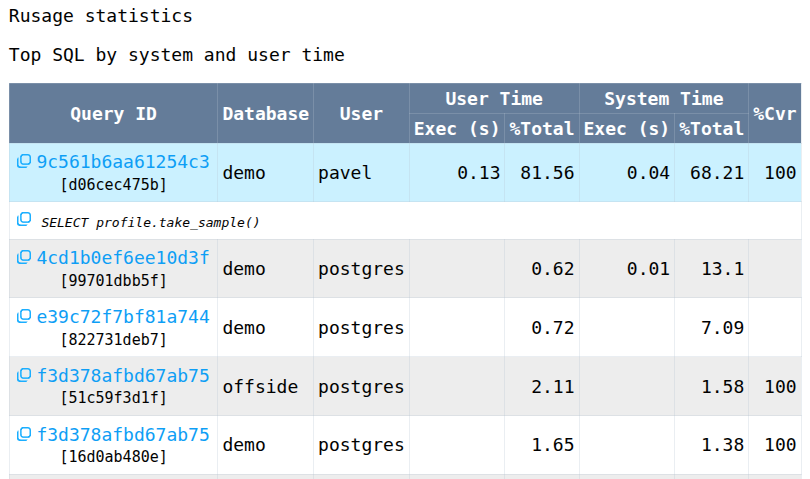

А тут посмотрим на результат работы расширения pg_stat_kcache.
Первая строчка — profile.take_sample(). И занимает выполнение этой функции более 80 процентов User Time! А ещё в отчёте же есть SELECT busy() — около двух процентов ещё.
Краткий итог
А я могу только повторить те выводы, которые были сделаны в моих экспериментах со статистическими представлениями (ну а что могло поменяться? эксперимент-то тот же):
«Изменение параметров генератора (gen.max_hops от 1 до 10) не привносят какого-то усложнения в расчёты.
Однако, если увеличить gen.max_hops до 10 — то postgres начинает больше обрабатывать страниц в памяти (рост pg_stat_statements.shared_blks_hit, я это тут не рассматривал). Эти страницы надо обрабатывать, поэтому-то процессор больше времени на это тратит, а не на сложные вычисления.»
На примере вышеуказанных (и не только) разделов pg_profile мы увидели что количество выполнений подпрограмм и их время почти не выросло, зато выросло количество обращений к страницам (Fetched (blk) → Shared). Мы посмотрели что чтений страниц с диска тоже почти не увеличилось (Read (blk) → Shared), а это означает что все чтения были выполнены из оперативной памяти.
А если поглядим на дополнительную информацию от pg_wait_sampling — то будет ещё круче:
Server statistics → Statement statistics by database:
~21 000 секунд
Server statistics → Wait sampling → DataFileRead:
~19 секунд
Если я всё правильно понял, то из 21 тысячи суммарных секунд (это на все процессы, а не реальное время) пришлось лишь 19 секунд на чтение файлов что в первом, что во втором вариантах. Так что все дополнительные чтения были в памяти.
В целом, в данной статье анализ отчётов pg_profile был осуществлён с одной целью — посмотреть разделы pg_profile, «потрогать» их руками на примере генератора демобазы. Особенно было интересно проводить параллели между разделами отчёта и теми статистическими представлениями, которые я ранее смотрел.
Дифференциальный отчёт get_diffreport будет рассмотрен в следующий раз.
Leave a Reply